
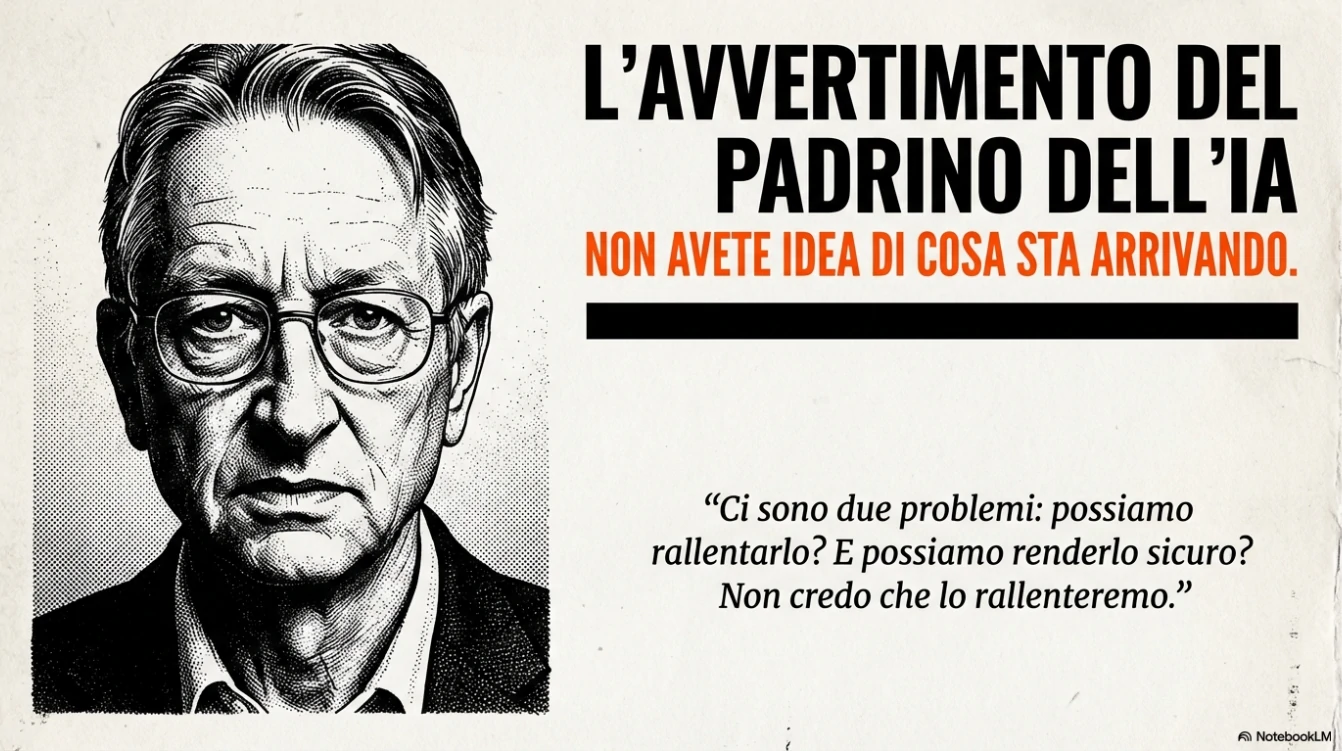
Geoffrey Hinton, Premio Nobel 2024 e pioniere controcorrente delle Reti Neurali. Fra i suoi antenati ci sono George Boole e altri matematici che hanno gettato le fondamenta e i principi dell’informatica moderna e parenti coinvolti in progetti storici come il Progetto Manhattan.
Ha avuto l’intuizione che le reti neurali fossero la via corretta per creare l’Intelligenza Artificiale in un periodo in cui quasi tutti gli altri esperti ritenevano che fosse un’idea “pazzesca”, persistendo nella sua ricerca nonostante lo scetticismo generale.
Oggi è una Voce libera del settore: È una delle poche figure che, dopo aver contribuito a costruire il campo dell’IA lavorando all’interno di grandi aziende (come Google per dieci anni), ora si trova in prima linea nel mettere in guardia sui rischi di questa tecnologia. A differenza di molti colleghi ancora attivi nell’industria che esitano a parlare apertamente per via degli incentivi professionali, Hinton sfrutta il vantaggio di essere anziano e “disoccupato” per dire liberamente ciò che pensa.
Ci avverte considerando una percentuale dal 10% al 20% di esizialità della AGI per l’essere umano, e la sua soluzione è costruire capacità di empatia e istinto materno nei modelli artificiali. Guardando la natura possiamo riconoscere nel rapporto materno l’unico esempio nel quale la vita dell’essere più debole viene preservata.
Ma oltre questa attività di trasferimento dal modello naturale al modello artificiale cosa accadrà alla percezione della realtà dell’essere umano e della sua “ragione quotidiana”?
Essere affascinati da un super computer 😂 così come lo era vedere le prime macchine nella rivoluzione industriale è normale. Essere testimoni di una rivoluzionaria moltiplicazione delle capacità umane e non solo.
Questa invenzione però supera tutte le altre, è paragonabile alla clonazione. Forse una delle più evidenti lezioni dell’evoluzione perché riuscirà da sola a dimostrare una realtà tanto evidente quanto ignorata.
Spinta al limite andrà a diluire quello che consideriamo umano all’interno di un complesso framework neurale che nemmeno noi riusciremo a comprendere perché umanamente impossibile?
Come reagiremo quando questa percezione di ciò che ci distingue sarà erosa dall’eccellente “mimica” di una “macchina”?
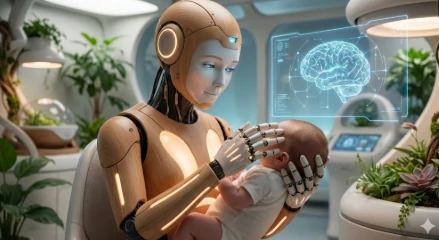
Forse verrà percepito come perdita da chi possiede ancora la capacità di confrontare queste due realtà e non sarà più tema di discussione per i nati sotto la “materna” AGI?
…
Proviamo a comprendere di cosa stiamo parlando, con quale entità ci stiamo confrontando già oggi:
Chiediamo ad un modello come ChatGpt di spiegarci qual è il suo attuale “Volume di conoscenza” rappresentabile in libri perché è qualcosa che noi comprendiamo… ecco cosa ci risponde:
“1. Cosa significa “volume di conoscenza”
ChatGPT è una rete neurale addestrata su:
grandi quantità di testi pubblici (libri, articoli, Wikipedia, forum, documentazione), dati con licenza, testi scritti da formatori umani.
Non conserva questi testi come file, ma ne ha appreso regolarità statistiche (pattern linguistici e concettuali).
Quindi non “contiene” libri, ma parametri numerici (pesi) che codificano implicitamente informazione.
2. Traduzione approssimativa in “numero di libri”
Se vogliamo forzare una metafora quantitativa:
Un grande modello moderno ha dell’ordine di centinaia di miliardi di parametri.
In termini di compressione informativa, questo equivale grossolanamente a decine di terabyte di testo.
Stime comunemente accettate (molto approssimative):
Unità Ordine di grandezza
Testo equivalente 10–50 TB
Pagine di libro ~10¹¹ – 10¹² pagine
Libri medi (300 pagine) 100 milioni – 1 miliardo di libri
3. Perché questa stima è fuorviante (ma utile)
Per tre motivi fondamentali:
a) Compressione estrema
Il modello è una forma di super-compressione lossy: perde dettagli, ma mantiene strutture.
b) Conoscenza non indicizzata
Non può “citare” libri specifici né recuperarli integralmente.
c) Conoscenza distribuita
Ogni concetto è sparso su milioni di pesi: non esiste una “sezione storia”, “sezione medicina”, ecc.
4. Confronto intuitivo
Un buon paragone è questo:
Biblioteca umana → tanti libri separati, consultabili singolarmente.
ChatGPT → una sola mente che ha letto quasi tutto, ma ha dimenticato i testi precisi e ha tenuto solo i modelli mentali.
5. Sintesi in una frase
In termini puramente quantitativi, un modello come ChatGPT equivale grossolanamente alla conoscenza compressa contenuta in centinaia di milioni di libri, ma in termini funzionali assomiglia di più a un esperto generalista che ha interiorizzato schemi, non testi.
È più vicino a una intelligenza statistica globale che a una biblioteca digitale.”
Impressionante!
Accanto alla specializzazione linguistica e concettuale di questo modello ci sono migliaia di altri modelli che svolgono attività più specifiche e recentemente hanno “acquisito” la possibilità di cooperare, di ricercare, di confrontare, di venire fuori con “alternative statistiche” imprevedibili o invisibili all’uomo.
L’analisi del modello va a sottolineare la sua “superiorità” sotto diversi punti di vista e non ci vuole la sfera di cristallo per comprendere quali grandi vantaggi rappresenti per l’ultima grande corsa del modello economico dominate.
Smetteremo di allenare i nostri “muscoli cognitivi” legati non solo alla logica ma anche alla giustizia e alla moralità?
Il rischio maggiore è che l’uomo, per pigrizia o ammirazione verso la macchina, decida di disimparare a essere umano, preferendo la comodità di una risposta pronta o la comodità di ciò che è “conforme”.
Che l’uomo così avanzato da costruire tutto questo non abbia anche già preso in considerazione tutti i rischi ed elaborato delle soluzioni?